
 最新跨境运营干货
 看多维度榜单信息
什么样的样本最容易骗人
最容易骗人的不是小样本,而是被选过的样本。小样本的问题在于信息少,看的人知道自己信息少,会留一道心;被选过的样本反过来,它信息不少、日期齐全、来源清楚,问题只在于它本来有许多个同样大小的兄弟段落,而被端出来的只是其中一个。
拿一个具体的场景说。上半年这六个月里,有三个月的数是整段里最亮的,你把这三个月单独拎出来看,得出的结论是这条路走得通。这个结论在三个月内部是对的,问题出在拎出来这个动作本身:如果你当初拎的是另外三个月,得到的会是完全相反的结论。
第二类容易骗人的样本是撞上了一次活动的样本。活动本身是真的,那段时间的销量也确实上去了,所以拿这一段说事的时候几乎无从反驳。要分辨的只有一点:这一段里有多少是活动带来的、多少是会留下来的。这两部分在数字上混在一起,只看总数分不出来。
第三类容易骗人的样本是分母悄悄变小了。卖得不好的那几条慢慢不做了,剩下的都是卖得动的,于是整体比例看着越来越好。这个时候量可能一点没涨,甚至还在降,可你会因为比例好看而判断情况在改善。这一类最不容易被发现,因为每一处单独看都没错。
这三类之外还有一种情况更隐蔽:数本身没有问题,问题是它被放在了一个不该放的位置上。一段只代表某个小范围的数,被当成全盘的参考用了。这种情况不是数骗人,是用法超出了它的适用范围。
分辨办法是先看这一段数覆盖了多少对象。覆盖得窄的数只能说明那一小块;要用它看全盘,就得先确认它和全盘的结构是不是接近。结构差得远的两批,一批好不代表另一批也会好。
还要留意一种相反的偏差:有些段落看着不好,其实是因为它被放在了最难的一段时期里。和前面那一种合起来看,会发现这两种偏差其实是同一件事的两面,都是把局部的表现当成了整体的表现。
有一个能快速自检的问题:如果这段数换成另外一段等长的、同样来源的数,结论会不会变。会变,说明你现在用的这一段不足以支撑这个结论;不变,说明结论靠的不是这一段本身的特殊之处。
还要提醒一点:不容易骗人的样本往往长得很普通。一段没有特别亮点、量级稳定的数,看着不如那一段最亮的有说服力,但它能被重复使用。人挑样本的时候天然偏好有故事的,而有故事的那一段恰恰是被挑过的概率最高的。
所以看一段数的时候,可以先问一句它为什么会被拿到我面前。是自己主动取的,还是别人指着它说的。别人指着说的那一段,通常已经经过了至少一次筛选,哪怕对方并没有恶意,他挑出这一段也是因为它显眼。
还有一个判断的方向是看它和前后比齐不齐。一段数如果和它前后的段落差别很大,那它本身就值得多问一层;差别不大,那它更可能代表这段时间的常态,用它来推断往后也更稳一些。
还有一类容易被忽略的是来源不明的样本。数是从哪里来的、由谁整理的、中间经过几道手,这些都说不清。这种样本的风险不在于它一定不准,而在于它出错的时候你没有办法查出来,因为链条上每一段都查不到。
来源不清的样本用起来要降一个等级:可以用来看方向,不要用来定数量。方向错了纠回来成本低,数量错了往往已经排进了备货和排期里,改起来牵扯的东西多。这个降级是主动做的,不是等出事之后再降。
把这几类放在一起看,会发现骗人的样本有一个统一的样子:它看起来比旁边的东西更值得信。要么更亮,要么更完整,要么更贴近你想听的话。一段无关紧要不痛不痒的数,从来不会骗到人,因为它不足以打动任何人。
这个特点带来一个很实际的用法:当你被一段数打动的时候,先按时把警惕提起来。打动这个感觉本身就说明这一段在众多段落里是特别的,而特别往往来自筛选、来自活动,或者来自分母。不是为了怀疑而怀疑,是因为特别需要解释。
还有一个看待这件事的角度值得说清:这三种情况都不是有人故意做出来的。绝大多数时候,人是在诚实地看数,只是看的时候不知道这一段已经被筛过一层。所以防它们不是防别人,是把筛选这个动作重新放回自己的视野里。
还有一类是时间特别短的样本。只看一周的数,很多事情都还看不出苗头,一周里刚好赶上什么,这一周就特别好看。判断这类样本值不值得用,有一个很朴素的尺子:这一段时间有没有跨过至少一个平常周期。没跨过的,看到的只是那一段时间本身的样子。
有一个更稳妥的做法是把短样本当预告用。它不能证明什么,但可以提示你接下来重点看哪一条。把注意力放到那一条上,过一段时间再看它有没有继续,比当场就下结论要靠谱得多。
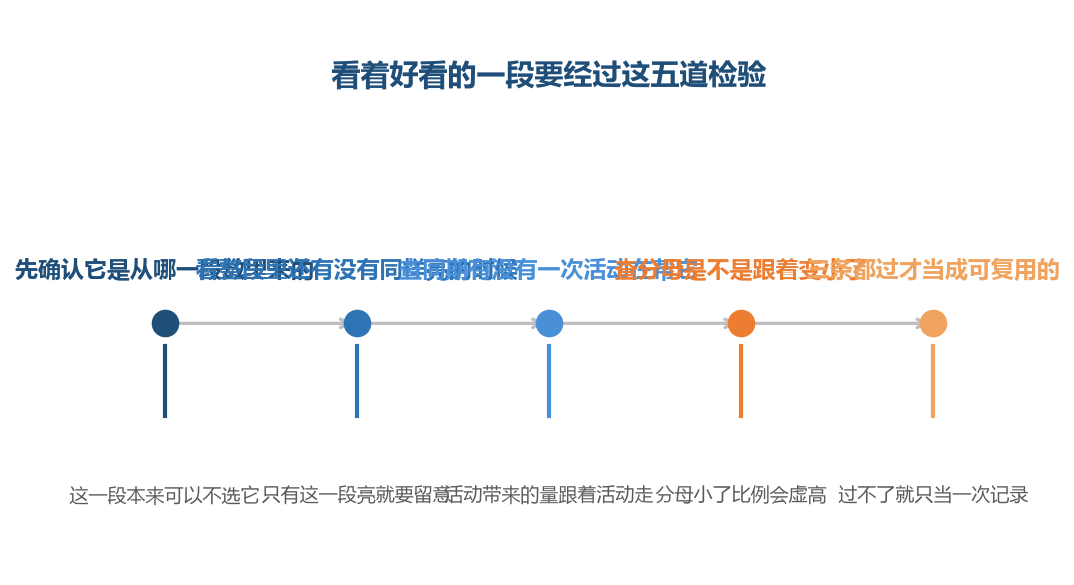
五道检验里第一道最容易被跳过,而它恰恰是另外两道的前提
情况一:挑出来的那一段
挑选这个动作有两种发生方式。一种是有意的,为了说明一个已经形成的看法,往回找一段支持它的数。另一种是无意的,人看长线的时候,注意力自然会落在起伏最大的那一段上,剩下的部分被当成背景带过去了。后一种更常见,也更难自查。
有一个很直白的自查办法:把整段按同样的长度切开,看这一段是不是其中最亮的一块。切法要事先定,不能切到最亮的地方就停手。多数时候切完之后你会发现,最亮的那一块和它旁边那几块之间的差别,没有你以为的那么大。
挑选带来的另一个问题是它同时把时间范围也定死了。一段数被拎出来之后,往后所有的讨论都在这段范围里进行,加进来的新数据反而会因为不合这个范围而被放在一边。范围跟着结论走,结论就再也改不了了。
还有一个连带效应和记录方式有关。如果日常记录只留了几个合计数,没留下每条明细,那么想换个切法重看一遍就做不到了。这时候挑选这件事已经没法回溯,你能做的只剩把整段长度和切法记下来,从今天起,往后每一段都按同一把尺子切。
挑段还有一种形式是挑对象,不挑时间。时间范围是完整的,但里面被提及的对象只是其中表现好的那几个。这种形式比挑时间更难察觉,因为时间范围看着是整段,没有任何缩短的痕迹,缩的是被拿出来说的那一部分。
举一个人造示例。上半年这六个月里有三千件,其中表现最靠前的那五条合起来占了一千二百件。你把这五条拿出来说,得出了这个方向很有潜力的结论。这个结论对这五条是成立的,对剩下那一千八百件并不成立,而后者才是多数。
挑对象和挑时间有一个共同的后果:它让你以为自己在看整体,实际上在看一个被选出来的子集。要防住这一点,做法是把整段的分母和被你拿出来说的那一部分同时写出来,两个数放在一起,比例自然就显出来了。
挑段还常常发生在跨年份的对比里。今年上半年和去年同期比,涨得很明显,于是你得出结论说方向对了。而去年同期恰好是那一年里最差的一段,拿它当基准,涨是当然的。这种对比看起来比挑时间更严谨,实际是同一个问题的另一个版本。
避免它的办法是把对比的基准也摊开看。不要只比一个点,把去年全年各段都摆出来,看今年的这一段在去年排第几。排在前列说明确实好,只比去年最差的那一段好,说明不了太多。
还有一个变体是拿自己最亮的一段去比别人的一般水平。你的这一段是你整年里最亮的一段,别人的那是他们的常态。这种跨对象的比较更容易得出过于乐观的结论,因为两边用的根本不是同样的挑选标准。
还有一种挑法更隐蔽,是挑指标。整段数里挑了那个最显眼的指标来说,其余的都略过。比如量没涨,但其中的一个比例涨了,就说这件事在改善。指标本身没造假,只是它被单独拿出来之后,代表的意思被放大了。
要防住这一类,做法是把几个相关指标一起看。量和比例、件数和人数、新客和老客,成对摆出来。单个指标好看而配对的指标相反,那多半就是挑指标这一段出了问题,而不是情况真的在改善。
挑段这件事有时候连日期都换了。本来统计的是自然月,为了让这一段更完整,改成按活动周期算;或者反过来,本来按周期算,为了截取最亮的那几周改成按自然月。日期跟着结论动,数是完整的,可比性没了。
要发现这种口径滑动,只能靠对比两次统计用的边界。把两次的起止日期写在同一行里并排看,边界差了几天的,就要留意是不是为了对齐结果而调的。差的那几天不显眼,但它足以让两个时段不可比。
还有一种是跨样本挑:手上同时有几批来源不同的数,挑了对自己有利的那一批拿出来说。这几批各自的来源不同、口径也不同,放在一起本来就没法直接比,用来互相支撑更像是凑数。
挑段在另一个人手上发生时还有一个变体:他会把整段里表现最差的那一段悄悄拿掉,理由通常也说得过去,比如那段时间在调整、那段时间外部环境特殊。理由可能都是真的,但拿掉之后剩下的这一段已经不是原来的整段,用它去推算往后,基数就偏了。
要发现这种手法,看的是整段里有没有缺一段。把连续的时间轴画出来,缺了的那一节是看得见的。有缺口的段落可以用来解释某一次结果,但不要用来做往后的基准,因为它的平均水平被抬过一次。
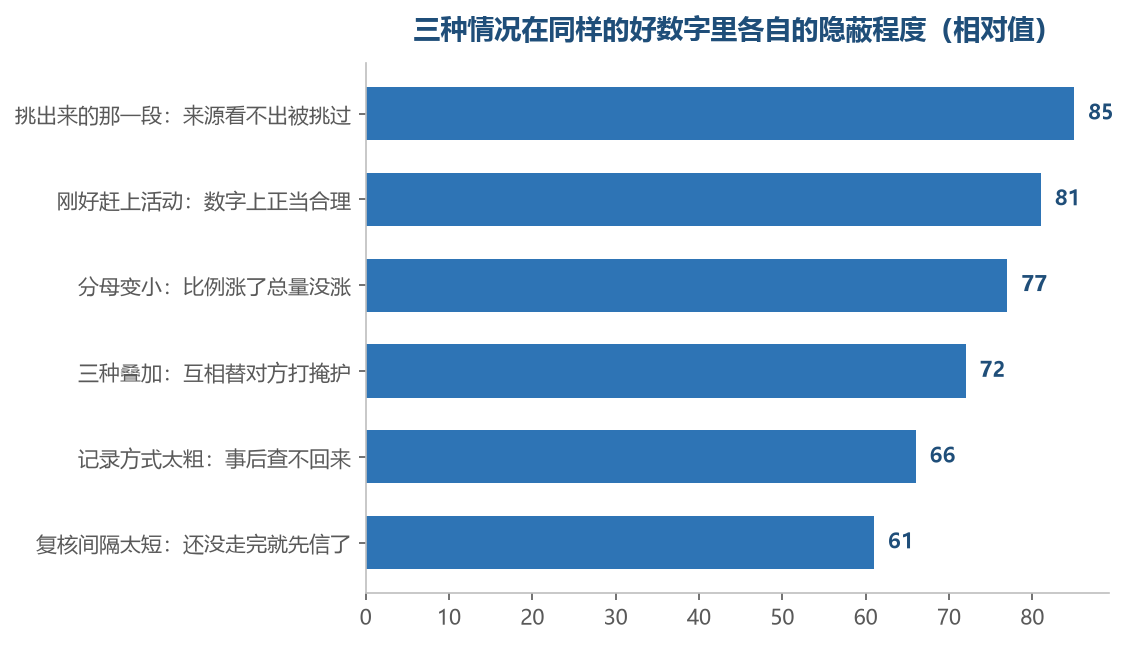
排在前三的三种里,第二种最难反驳,因为活动期间它确实是真的
情况二:刚好赶上的一次活动
活动期间的量的构成很特别。一部分是本来就会买的人提前买了,一部分是本来不打算买的人被价格带动了,还有一部分是活动之后本来要买的人提前买了。这三部分的总和让活动那几天特别好看,而其中只有中间那一部分算真正的新增。
提前买的那两部分有一个特征:它们会在活动结束后变成一段低谷。所以判断一次活动到底带来多少,看的不是活动那几天涨了多少,而是活动前后各一段时间合起来算,还是不是比平常高。只看活动那几天,几乎每一次活动都会显得很成功。
这也是活动样本最难反驳的原因。它不像挑段那样有明显的手工痕迹,也不像分母变小那样能在比例和总量上找到矛盾,它就是一段真实发生过的、量确实更高的时间。要把它分开,只能靠前后各留一段同样长的时间做对照。
如果当时没有留出前后对照的时间,补救的办法是把同期的同类拿来比。活动期间所有同类都在涨,你的涨幅和它们差不多,说明这一段里的大部分是活动带来的;明显高出一截,高出的那部分才值得单独看。这个比较不需要事先准备,事后能做。
活动还有一种情况是活动本身没带来多少,但同期有没有活动改变了人的判断。知道你参加了活动,就会倾向于把这段时间的量归给活动;不知道,就会归给自己做的其他事。同一段数,归因不同,后续的动作完全不同。
要分清这两种,有一个朴素的办法:把同一段时间里没有参加活动的那些对象也拿出来看。它们如果也在涨,说明这段时间外部条件普遍在动,活动的贡献被高估了;它们平着,只有参加活动的那几条在涨,活动的贡献才算清楚。
还有一个容易混淆的地方是活动的结束时间。活动的日期是官方的那几天,但量的回落往往要拖到之后一段。把结束日期当成回落完成的日子,会把还在往下走的那一段算成活动的成果,看起来活动很有效。
活动样本另一个麻烦是它会重复出现。同一种活动一年办好几次,第一次的经验会被拿去指导第二次。而第二次的外部条件已经变了,第一次有效的做法未必还成立,这一点在只看活动那几天的数据时完全看不出。
活动期间还有一种量来自价格以外的因素,比如活动的页面本身更好找、入口更显眼。这部分带来的量和价格无关,活动结束之后入口撤了,它也跟着走。把这一段全归给价格,下次只调价格不参加活动,两边就对不上。
要把价格和入口分开,可以看活动期间涨的那部分集中在什么价位上。集中在低价位,说明价格起了主要作用;各个价位都有,说明更多是人流变多了。这个判断不需要额外准备,活动期间的明细里就带着这些信息。
活动样本还有一个特点:它会让平时不显眼的那几条也变得显眼。平常卖不动的那几条在活动期间也涨了一些,活动结束后回到原位。如果只看活动期间,会误以为这几条其实有潜力,为它们排上后续资源。
分辨这一点很简单,就是看活动前后同一条的状态有没有变化。活动期间涨、结束后回到原来的档,说明它只是被活动带了一下;结束后停在比原来高的档,那才是真的变了。这两种在活动期间是一模一样的。
还有一种情况是活动带来的量被重复计算了。同一个变化既记进了这次活动的成果,又记进了日常运营的成果,两边加起来超过实际。这种事在多人分工的团队里很常见,每个人看自己那一块,都没有多算,合起来就多了。
要避免它,需要有人把整段量按来源分一遍,确保每一份只归给一个原因。分的办法不必很细,能覆盖住主要的那几项就行。这一步做完之后,两边加起来刚好等于总数,多算的部分自然就露出来了。
活动期间还有一种难以察觉的成分是大环境。某一次活动刚好落在一段普遍上涨的时期里,看起来是这次活动做得好。实际上同时期的其他店、其他类目也在涨,这次活动的真实贡献被大环境抬高了。
分辨的办法还是那个:找同期没有参加活动的对象做对照。它们涨得和你差不多,说明这一段里的大部分来自大环境;它们平着只有你在涨,那才是活动的功劳。这个对照事后做也来得及,只是要有意识地想到。
活动样本的处理还有一层考虑是要不要用它来做下一年的计划。用它做计划,前提是下一次活动的条件和这一次接近,包括时段、形式、投入。这几项只要有一项差得远,上一次的表现就不能直接搬到这一次。
活动期间还有一种变化和价格无关,是同类在被挤压。活动把流量吸到了少数地方,同期没参加活动的对象表现反而更差。这时候拿同期没参加活动的来做对照,会高估活动的贡献,因为对照那一批本来就被压低了。
要避开这一层,对照要选得更远一点,选那些和活动对象结构接近、又没有处在同一竞争位置的。或者在活动前后各留出一段平静期做基线,用基线来算活动的净增,比用同期比更稳。
| 看到的形态 | 更可能是哪一类 | 怎么查出来 | 查出来之后怎么用 | ||||||
|---|---|---|---|---|---|---|---|---|---|
| 半 | 年 | 里 | 最 | 亮 | 的 | 三 | 个 | 月 | |
| 被 | 挑 | 出 | 来 | 的 | 那 | 一 | 段 | ||
| 按 | 同 | 样 | 长 | 度 | 把 | 整 | 段 | 切 | 开 |
| 改 | 用 | 整 | 段 | 来 | 看 | 这 | 一 | 段 |
情况三:分母悄悄变小了
分母变小通常不是一次决定,而是一连串小决定攒出来的。有几条一直卖不动的,慢慢就不做了;有两个一直不合适的价位,慢慢就不铺了。每一个决定当时都有理由,拼在一起的结果是留下来观察的那一批本身就被筛过一遍,比例自然会好。
这一类的典型样子是比例涨而总量不动。你看到的是合格的比重从三成涨到了四成,感觉结构在改善;而实际的件数从一百件掉到了八十件,合格的那部分从三十件变成了三十二件,几乎没变。比例上的改善,全部来自分母少了二十件。
分辨它的办法很简单,就是每次看比例之前先把分母摆出来。分子分母一起看,比例涨而分母在缩的情况一眼就能分出来。这个动作只需要一行字,但要成为习惯不容易,因为人看比例的时候视线只在比例上。
还有一个更隐蔽的样子是分母换了成员。数量没变,进来的那几条换成了另几条,比例看着也没怎么动,可是它衡量的已经是一批不同的对象了。这种情况下连分子分母一起看都不够,还得知道这一批里有没有换过成员。
分母变小还有一种是同步发生的:一批对象被下掉了,同时有一批新上来的补上,数量看着没变。新的那批还没积累到足够的时间,表现普遍还没有出来,于是整体比例被拉下去。这时候看着是变差,其实只是构成新了。
遇到这种构成变化,能做的第一件事是把新旧两批分开算。分开之后往往会看到,老的那一批并没有变差,新的一批只是还没到时候。混在一起算出来的比例,对两批中的任何一批都不成立。
还有一种分母变化来自统计范围本身:某一次统计把一部分对象算进来了,下一次又没有算。这种变化在表面上不留痕迹,比例却会因此浮动。要发现它,只能靠每次统计时把范围记一笔,事后再对着看。
分母变小还有一种来自时间:有一部分对象的观察时间还没有走完。比如这个月新上来的几条,只跑了两周,就把它们放进整月的统计里,整体的平均值会被拉低。而这几条本身并没有表现不好,只是还没到时候。
处理这种时间不齐的做法是把观察期还没走完的对象单独放一列,不要混进整体里。等它们跑满一个完整的周期之后再并进去。这样每一期的分母都站在同一个时间基础上,前后才比得了。
还有一种是分母被重复计算了。同一条被不同的入口各算了一次,整体的分母虚高,比例被压低。这和前面说的分子多算一份刚好相反,一个让数看着好,一个让数看着差,共同点是两边都算不准。
还有一种分母变化来自对象的归属。某几条从这一类挪到了那一类,两边的分母各变了一次。如果只看其中一边,会得到互相对立的两个结论:一个说这类在做大,另一个说这类在萎缩。两个都对,只是各自看了一半。
处理这种归属变动,最省事的做法是在变动发生的那一天记一笔:哪几条从哪挪到了哪。有了这一笔,往后看任何一边的数,都能知道它的变化里有多少来自挪动、有多少来自真实的增减。
分母变小时还有一个连带问题:剩下那批对象的质量看着更好,于是你按这个印象给它们配资源。资源配上去之后,量确实上来了,因为资源本来就会带来量。这两件事加起来,会让你更加确信这个结构是对的,而结构其实一直没变。
要把资源带来的量和本身的质量分开,做法是留几条没配资源的做对照。同期没配的那几条如果走势和配了的接近,说明这些量本来就该来;差得明显,那部分才是资源的作用。这一步不需要做得很精细,留几条就够。
还有一种分母变小是本该发生的,比如过季了、某个样式退役了。这种不该当成问题,只需要在记录里标明原因。麻烦的是它和不该发生的那些在数上看着一样,所以每一次分母变化都值得顺手写一句原因。
要分清楚修正和范围变化,看的是修正前后哪些对象进了哪些出了。如果进来的和出去的都是零散的个别条目,多半是修正;如果成批地进或者成批地出,那就是范围改变了,比例和总量都要重新看一遍。
分母变小还有一层和观察者的关系:分母小的地方通常看得更细,看到的起伏也更多,于是判断更容易频繁变化。分母大的地方看着平稳,判断反而不容易变。同一个东西换一个分母看,得到的稳定性完全不同。
三种情况的共同点
第一个共同点是它们都发生在看数之前,而不是看数的时候。挑段是在你打开数之前就完成的,活动的量是在那几天就已经形成的,分母是在前面几个月一次一次变小的。等到你坐下来看,这三种情况都已经成为数本身的一部分,不在你的视野里。
第二个共同点是它们都能在数字内部自洽。挑出来的那一段自己前后连续、有日期、能加减;活动期间的量确实发生过;比例和分子的变化也都算得出来。正因为自洽,靠盯着这一个数看是怎么也看不出来的,缺的是这个数之外的东西。
第三个共同点是它们都有正面的说法。挑段可以叫聚焦重点,赶上活动可以叫抓住了机会,分母变小可以叫优化了结构。这三个说法都不是狡辩,在别的情况下都成立。麻烦在于它们和真实情况用同一套话术,听不出区别。
第四个共同点是它们让你的判断偏向乐观,而且是那种查不出来的乐观。数字本身没有改过,判断也经过了看数的过程,但从一开始,被观察的这一段就已经被筛过一次。之后做的所有分析,都建立在这次筛选上,而且越分析越加固。
第四个共同点还有一层延伸:它们都会在解释里留下一个说不通的地方,而人会自动把这个地方补上。量涨了而你说不出原因,人会顺势找一个听起来合理的理由填上,比如最近内容做得不错。这个补上的理由往往就是错的开始。
所以遇到说不通的地方,更好的处理是把它标成一个待查的点,而不是马上补一个理由。标出来的待查点会在下一次复核时被带上,补出来的理由只会成为你判断里的一块新砖,而且它是虚的。
它们还有一个共同的处理原则:不要在那个当下去争论这个数准不准。准不准要等有对照才能说清。当下能做的只是把它和对照摆在一起,摆出来之后,多数争议自己就消解了,因为没有对照的争论本来就没有落点。
把对照摆出来这件事也有一个技巧:对照要尽量和它等长、等结构。用一个月比三天,用整店比一个类目,比出来的差别里大部分来自两边不匹配,而不是来自你真正想知道的那个变化。
这三种情况都会影响一件事:你对这个数能不能重复的判断。挑段出来的数往往只能重现一次,活动带出来的数在活动条件不变时能重现,分母变小带出来的数在下一次分母继续变小的时候还能看着很好。判断能不能重复,先要看清自己碰上的是哪一种。
知虾把站点、日期和层级标清楚,看的是这几级的公开信息。它不做采集,也拿不到你后台那一层的数据。所以分母里属于你自己经营的那一部分,只能由你自己的记录来补,这一块没有别的来源,也没有别的办法绕过去。
这三种情况还有一个共同的时间特征:它们都在看到结果之前就发生了。挑段发生在你决定看哪一段的时候,活动发生在你决定参加的时候,分母变化发生在你决定下掉哪几条的时候。三个动作当时都各有各的理由,合起来才把数改了一遍。
因为发生得早,事后回头查的时候,能查到的只是数变了,查不到当时的决定是怎么做的。所以要留下的是决定本身:哪一天划的时间范围、哪一天参加的活动、哪一天下掉了哪几条。这几行记录比数本身更能解释这一段为什么长这样。
所以处理这类问题最实用的动作不是分析,而是留痕。留下划分范围的那一天、留下活动起止的那几天、留下下掉和新增的那几条。留下的这几行不需要复杂,但它们是往后所有解释的依据。没有这几行,再好的分析也只在当时成立。
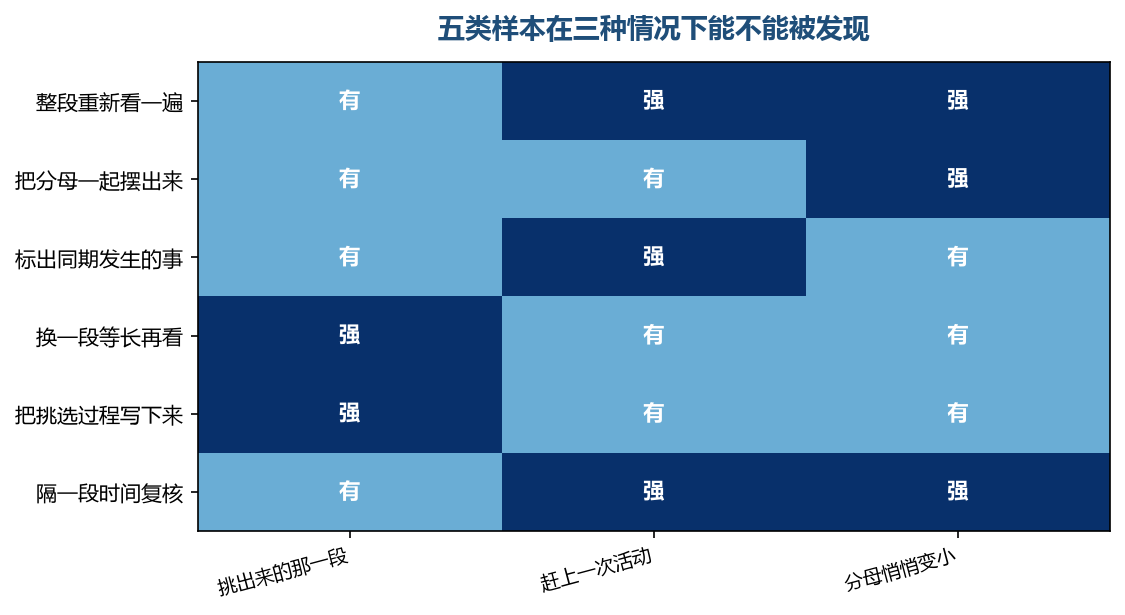
没有哪一项能一次全看出来,但每一项都能看出其中一类
怎么识别自己拿到的是哪一类
第一件事是问这段数从哪来。是随手打开的整段,还是为了说明什么专门找过的。问这一句不需要任何工具,只需要诚实。如果是专门找过的,接下来所有分析都要带上这一层前提,别把它当成一段普通的数。
第二件事是查时间范围是谁定的。范围定在看数之前,还是定在看到结果之后,区别很大。定在之前,范围是客观的;定在之后,范围多半是顺着结果往两边收的。这条查起来也很简单,看范围的两个端点是不是落在了几个整齐的时间点上。
第三件事是看分母有没有变化。把这一段的分母和上一段的分母摆在一起,差别超过多少就该留意。分母的变动往往有正当理由,但不管理由是什么,只要分母变了,比例和上一段的就直接比不了,必须把分子分母分开比。
第四件事是标出同期还发生了什么。一次活动、一次改价、一次换图,都会在这段数里留下痕迹。把这些事的时间点标在数的旁边,多数时候能自己看出来这一段里哪一部分是自己可控的,哪一部分是外面来的。
有一件事值得单独说明:这三种情况不冲突,多数时候是叠加的。一段数既是被挑出来的,也刚好赶上了一次活动,同时分母还变小了。叠加之后,任何单一角度的检验都会过,因为它旁边总有另外两层在替它挡。
所以分辨的顺序要固定下来。先查来源和范围,再看分母,最后看同期发生了什么。这个顺序不能颠倒,因为后两项都需要在来源清楚的前提下才有意义。来源不明的数,查分母和查同期都是在沙子上做功夫。
知虾给的是站点、类目、商品这几级的公开信息,把每个数落在哪一层标出来,看的是这一层。它不做采集,也拿不到你后台那一层的数据。所以来源和范围这两项的前一半可以由它标出来,剩下的那一半仍然要从你自己的记录里来。
这几件事之外还有一件不太像方法但很有用的做法:找一个人把这一段数讲一遍,讲的时候不要带上你的结论。对方听完自己会得出什么,是你这段数的中立版本。对方得出的和你想要的不一样,说明你手上的数并不支持那个结论。
讲给别人听还有一个副作用,就是你会被迫把条件说清楚。平时自己在脑子里过的时候,很多前提是默认的,不会说出来。一旦要开口讲,那些默认的前提会浮出来,其中有一部分你自己都会觉得站不住。
讲给别人听的时候,尽量别用自己习惯的词。习惯用词会把你默认的前提一起带进去,听的人接受得很快,反而问不出问题。换成最朴素的说法讲,把每一层条件都说出来,对方的追问才可能落在真正薄的地方。
还有一个更省事的自检方式:把这一段的结论写成一句话,然后在纸上把支持它的数标出来。标完之后看这些数覆盖了多长的时间、多少的对象。覆盖得窄而结论下得大,就是典型的问题所在。
还有一个判断的信号看时间:这一段数是看数之前就定下来的,还是看数之后才划出来的。看数之前定好的,几乎不会是挑出来的;看数之后划出来的,就要多问一层为什么划在这里。这一条只能自问,别人帮不上忙。
另外一条是看这个结论多久之后被拿去用了。看完之后马上拿去做安排的,通常没验过;看完先放着、过一阵再拿出来的,中间多少有一点自然的检验。这个间隔的长短,本身就能说明这个判断被对待得有多谨慎。
这几件事里最容易被跳过的是问来源。因为它不需要任何工具,也不需要等,正因为太容易,反而常常被略过。人遇到一段好数,第一反应是往下想它意味着什么,而不是先回头看这段数是怎么到手上的。
有一个能把它变成习惯的做法,是在记录里给每一段数留一个填来源的格子。填过几次之后,看到手上那些没有填来源的段落,会自然地感觉到不踏实。这种不踏实就是习惯形成的样子。
这四件事不需要每次都做完,也不需要做得很细。多数时候问来源和查分母这两项就能筛掉大半问题,剩下的那两项留给量比较大、影响比较远的判断。分轻重地做,才能长期做下去。
这几件事之外还有一个很省事的办法:看这个结论对不同起点的敏感程度。把起点往前挪几天、往后挪几天,结论基本不变,那它更可能站得住;结论跟着起点动、挪几天就换一个说法,那这一段本身就有问题。
敏感度测试还有一个好处是它不需要额外数据。手上的数就能做,几分钟能出结果。做过一次之后,你对这一段到底有多结实,心里会有一个具体的印象,而不是只凭它看起来好不好。
还有一个判断的入口是看这个结论有没有一个能反驳它的说法。能想出一条什么样的结果会让这个结论不成立,说明这个结论是有边界的;想不出来,说明它太宽,宽到不管发生什么都能解释,那这样的结论其实没有说明任何事。
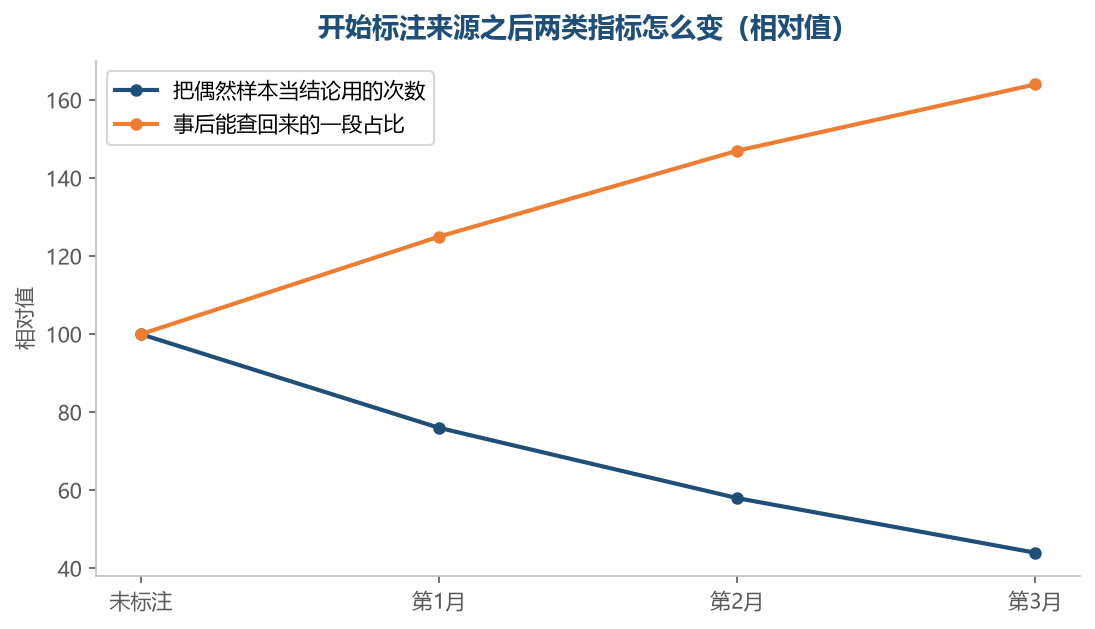
标注这件事不改变数,只改变这个数能不能被复用
不确定的时候该怎么做
不确定的时候第一件该做的事,是把这一段当成一次记录而不是一条结论。记录的含义是它只说明这段时间发生过什么,不说明以后还会发生。这个定级看起来退了一步,实际降低了后面所有安排的风险,因为它们不会建立在还没验过的东西上。
第二件事是给自己定一个复核点,而且要定在变化发生之后、而不是之前。前面几篇讲过这个做法,放在这里同样适用。定在之前意味着你还没看到数就先认定了它会好,那时定的复核点往往会变成走过场。
第三件事是把不可逆的动作往后挪。备货、排期、加投入这类动作,一旦做出去就要等一段时间才能收回,属于不可逆的那一批。分辨不清的时候,先把这类动作放着,同期的可逆动作照常做,等复核点到了再一起决定。
第四件事是把当时的条件写下来。这一段数是在什么条件下出现的、当时外面还有哪些事在变、分母是多少、范围是谁定的。写下来花不了一分钟,但半年之后回头再看这一段的时候,有没有这几行决定了它还查不查得回来。
还有一点要坦白说:这三种情况没有一个能被彻底排除。哪怕把该查的都查了,仍然会剩下一些说不清的部分。可行的做法不是把说不清的部分消掉,而是给它留出余量,动作排得松一点,别把所有的位置都占满。
还有一件事是接受这一段数只能用在有限的地方。它不能用来做长期的安排,但可以用来做一次性的检查,比如确认某一类对象的走向和预期一致。把用处缩小到它撑得住的范围内,这一段数就不是白拿的。
如果这一段数过了一段时间被验证了,那就把它从记录升格成一条能用的判断,同时把当时验的过程一并写上。如果没被验证,也把它留下来,标清楚它是没成立的。没成立的记录同样有用,它挡住的是你以后重复同一个判断。
有一件事不要做,就是为了让这一段数看起来更可靠,再去找几段类似的好数来支撑。找几段类似的好数很容易,因为总会有。把几段都是好数的段落凑在一起,只会让偏差叠加,不会让它变准。
反过来,主动去找和它相反的那几段才是有用的。找到之后对比一下两边的条件差在哪里,差的那一项往往就是决定性的那一项。这一步比继续加固原有结论有用得多,只是做起来不太顺人心。
还有一件事是给这一段数写一个失效条件。什么情况下它就不再适用了,比如分母掉到多少以下、外面出现什么变化。写下来之后,这一段数在往后就有了自己的边界,不会因为看起来还成立就一直被用下去。
最后要说的是,这些做法都不是为了让手上的数变得完美。手上永远会有说不清的部分,做这些只是把说不清的部分挪到台面上,让它不参与决定。留在台下的那些,才是真正会出问题的地方。
还有一个做法是暂时不用这一段,先去做别的。分辨不清并不等于要停下来,别的部分照常可以推进,只是不把这一段当成依据。等过一段时间再看,很多当时纠缠不清的地方会自己变清楚,因为多了一段可以对照的时间。
如果非要用这一段,那就把不确定的那部分单独标出来,动作只押在确定的那一部分上。比如量里确实有增加,但增加的来源不清楚,那可以按增加的事实调整,但不按来源的解释去改做法。
最后一件要做的事是记录这次没弄清楚的经过。把当时看到什么、试了哪几种查法、剩下哪一项查不出来,写三五句就够。下一次遇到类似的情况,这几句能直接省掉前面那几步的摸索。
还有一件事是不要把判断往后拖当成拖延。拖和等的区别在于,等的时候你知道自己在等什么、等多久、等到了看什么。有这三样,等就是有安排的;没有这三样,等只是把问题放一放。
等的这几样也可以先写下来:等的是哪一类信号、大概要等到什么时候、到了那天看哪几个数。写下来之后,这一段时间里你就不必反复回来想这件事,注意力可以放心地给别的地方。
最后一点是这一段数说到底是别人的判断还是自己的观察。别人给的一段数,哪怕好看,也只能作为线索;自己动手看过的这一段,哪怕平常,用起来更有底。分辨这两者,比分辨数高低更有用。